
Options
- Mark as New
- Bookmark
- Subscribe
- Mute
- Subscribe to RSS Feed
- Permalink
- Report Inappropriate Content
02-03-2026 05:07 AM - edited 02-03-2026 05:09 AM
Hi @ajay_wavicle ,
Azure Databricks automatically creates a SparkContext for each compute cluster, and creates an isolated SparkSession for each notebook or job executed against the cluster.
So following should work in python module in Databricks Workspace (use spark variable):
col_df = spark.sql("SELECT * FROM  dev_factoring.information_schema.columns")
display(col_df)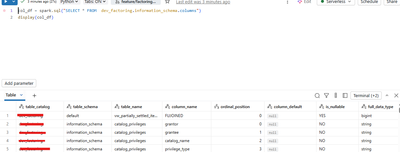
Another approach would be to create session explicityl using following:
from pyspark.sql import SparkSession

spark_session = SparkSession.builder.getOrCreate()
col_df = spark_session.sql("SELECT * FROM  dev_factoring.information_schema.columns")
display(col_df)